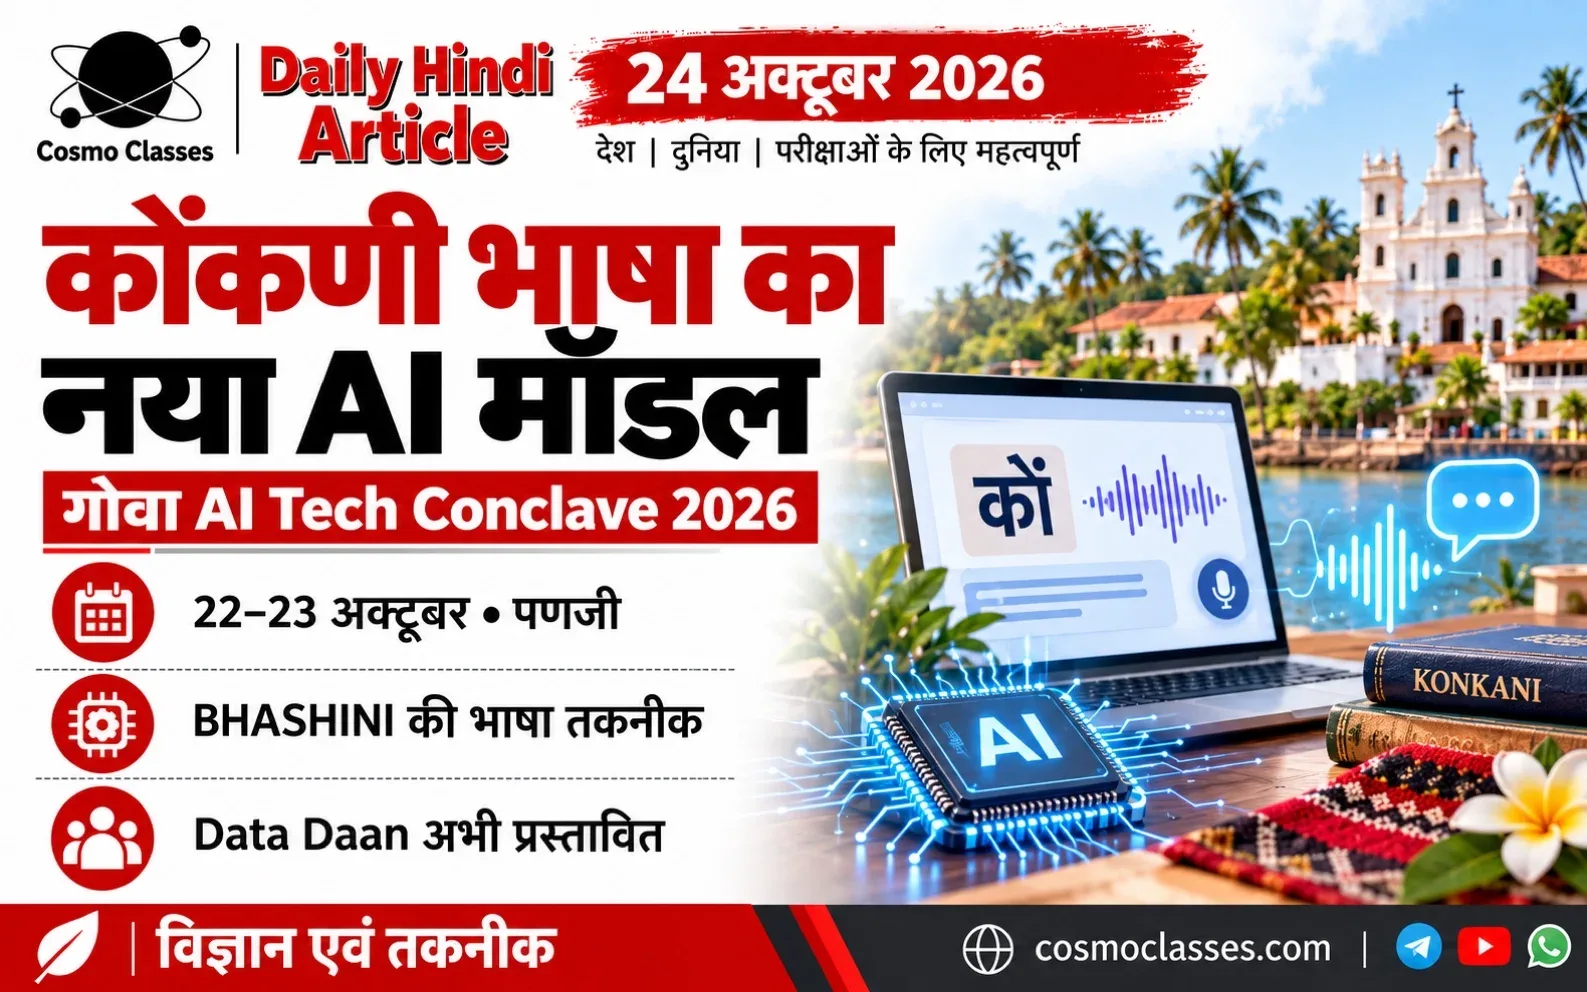
- इलेक्ट्रॉनिकी और सूचना प्रौद्योगिकी मंत्रालय की 23 अक्टूबर 2026 की विज्ञप्ति के अनुसार Goa AI Tech Conclave 2026 में BHASHINI कोंकणी Large Language Model (LLM) लॉन्च किया गया। सम्मेलन 22–23 अक्टूबर को INOX, पणजी में आयोजित हुआ। इसका विषय AI for People, Planet and Progress था।
सम्मेलन में क्या प्रदर्शित किया गया?
- BHASHINI ने भाषण का वास्तविक समय में अनुवाद और लिखित रूपांतरण प्रदर्शित किया। इसमें कोंकणी से अंग्रेजी तथा अंग्रेजी से कोंकणी संचार के उदाहरण शामिल थे। मॉडल की पहल भाषा के शब्दों, अभिव्यक्तियों और सांस्कृतिक संदर्भ को डिजिटल तकनीक में बेहतर प्रतिनिधित्व देने से जुड़ी है।
- विज्ञप्ति में Data Daan pilot को प्रस्तावित कहा गया है। इसका विचार शिक्षण संस्थानों, भाषा विशेषज्ञों और कोंकणी समुदायों के सहयोग से सामग्री निर्माण, डिजिटलीकरण तथा सत्यापन बढ़ाना है। इसलिए LLM के लॉन्च और Data Daan के प्रस्ताव को एक ही पूर्ण हो चुकी उपलब्धि के रूप में नहीं लिखना चाहिए।
LLM, अनुवाद और transcription में अंतर
- Large Language Model भाषा के बड़े संग्रहों से पैटर्न सीखने वाला AI मॉडल होता है। इसका उपयोग पाठ समझने, उत्तर तैयार करने और भाषा संबंधी कार्यों में हो सकता है। किसी मॉडल का लॉन्च उसकी हर परिस्थिति में पूर्ण शुद्धता का प्रमाण नहीं है। स्थानीय बोली, विषय और प्रशिक्षण सामग्री के आधार पर परिणाम बदल सकते हैं।
| शब्द | सरल अर्थ |
|---|---|
| LLM | भाषा पर प्रशिक्षित बड़ा AI मॉडल |
| Transcription | बोली गई बात को लिखित पाठ में बदलना |
| Translation | एक भाषा का आशय दूसरी भाषा में व्यक्त करना |
| Text-to-Speech | लिखे पाठ को आवाज में बदलना |
| Human validation | मनुष्य द्वारा परिणाम या डेटा की जाँच |
- उदाहरण के लिए, किसी वक्ता की कोंकणी बात को कोंकणी में लिख देना transcription है। उसी बात को अंग्रेजी में व्यक्त करना translation है। यदि अंग्रेजी परिणाम को आवाज में सुनाया जाए तो भाषा प्रसंस्करण के साथ speech generation भी जुड़ता है। इन अलग चरणों को समझना विज्ञान एवं तकनीक के प्रश्नों में उपयोगी है।
भारतीय भाषाओं के लिए डेटा क्यों जरूरी है?
- भाषा केवल शब्दों का संग्रह नहीं होती; उसमें स्थानीय संदर्भ, मुहावरे और उच्चारण भी शामिल हैं। पर्याप्त और विविध डेटा के बिना AI कुछ समूहों की भाषा को कमजोर ढंग से समझ सकता है। इसी कारण साफ डेटा, सही लिप्यंतरण और भाषा विशेषज्ञों की समीक्षा उपयोगी हैं। अधिक डेटा होना और गुणवत्तापूर्ण डेटा होना एक जैसी बात नहीं है।
- इस पहल का संस्थागत संबंध Digital India BHASHINI Division, Digital India Corporation और MeitY से है। BHASHINI भाषायी डेटा, मॉडल, API और अनुप्रयोगों को जोड़कर भारतीय भाषाओं में डिजिटल सेवाओं की पहुँच बढ़ाने पर काम करता है। कोंकणी का उदाहरण भाषा संरक्षण तथा तकनीकी पहुँच के संबंध को समझाता है।
कोंकणी और संविधान: Static GK
- कोंकणी, मणिपुरी और नेपाली को 1992 में 71वें संविधान संशोधन द्वारा आठवीं अनुसूची में शामिल किया गया था। भाषा की संवैधानिक मान्यता और किसी नए AI मॉडल का विकास अलग घटनाएँ हैं। 2026 के तकनीकी समाचार के कारण भाषा को उसी वर्ष संवैधानिक मान्यता मिली—ऐसा निष्कर्ष गलत होगा।
परीक्षा उपयोगी तथ्य
- समाचार का स्थान पणजी, गोवा, तकनीकी शब्द LLM, संबंधित मंच BHASHINI और मंत्रालय MeitY याद रखें। Data Daan अभी प्रस्तावित है। वास्तविक समय का प्रदर्शन और सभी सेवाओं में व्यापक कार्यान्वयन अलग स्तर हैं; विज्ञप्ति में जितना स्पष्ट है, उत्तर उतना ही निश्चित रखें।